ローカルLLMはメモリ16GB・36GB・64GBのMacで何が変わる?手持ちの4台で同じテストを回して分かった、載る大きさ・速さ・落とし穴
「ローカルLLMをやるなら、Macのメモリはどれだけ要るの?」
「16GBだと、何も動かないの?」
「64GBにしたら、何が変わるの?」
手元に、メモリ16GB・36GB・64GBのMacが4台そろいました。2020年のMacBook Air(M1・16GB)、Mac mini(M6・16GB)、MacBook Pro 14インチ(M3 Pro・36GB)、同じ14インチのMacBook Pro(M5 Max・64GB)です。
せっかくなので、4台に同じ文章と同じ音声を渡して、ローカルLLM(AIのモデルをダウンロードして、自分のMacの中だけで動かす使い方)がどこまで動くかを測りました。
数字は目安です。どの条件も測ったのは1〜2回で、ほかのアプリを開いたままのMacもあります。
測ったのはどのMac? 条件は?
4台はこちらです。
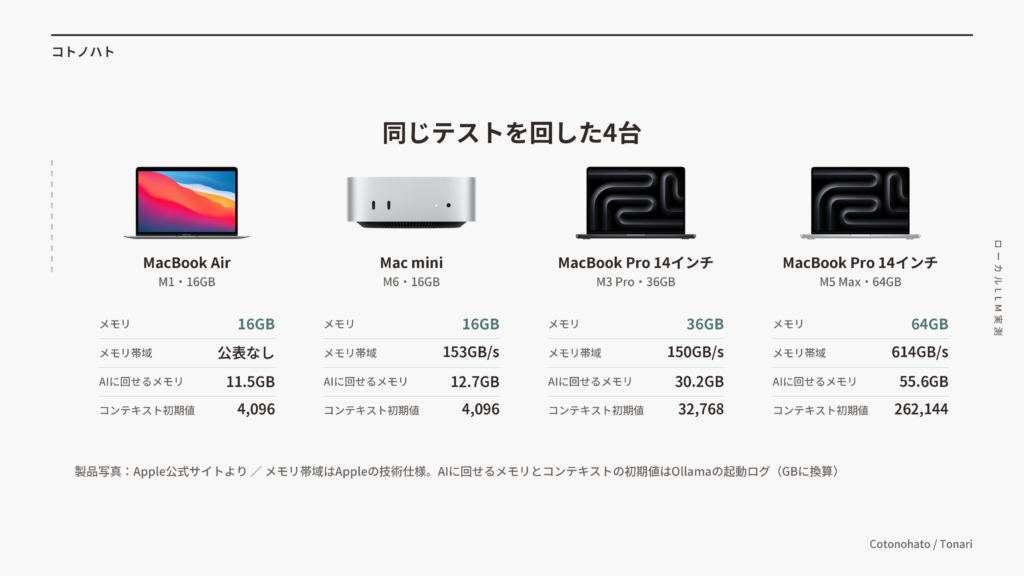
| MacBook Air(M1) | Mac mini(M6) | MacBook Pro 14インチ(M3 Pro) | MacBook Pro 14インチ(M5 Max) | |
|---|---|---|---|---|
| メモリ | 16GB | 16GB | 36GB | 64GB |
| メモリ帯域 | 公表なし | 153GB/s | 150GB/s | 614GB/s |
| AIに回せるメモリ | 11.5GB | 12.7GB | 30.2GB | 55.6GB |
| コンテキストの初期値 | 4,096 | 4,096 | 32,768 | 262,144 |
| ファン | なし | あり | あり | あり |
出典:メモリ帯域はAppleのMac mini技術仕様ページ、AppleのMacBook Pro技術仕様ページ、Appleサポートの「MacBook Pro(14インチ、2023年11月)技術仕様」。Appleサポートの「MacBook Air(M1、2020)技術仕様」には帯域の記載がありません。ほかの行は自分の実測(Ollamaの起動ログの値をGBに直したもの)
前回の動画「M6 Mac miniを最小構成にした5つの理由」で、メモリを机、AIのモデルを大きな辞書に例えました。今回もその例えでいきます。辞書が机に載るかどうかで、そのモデルが動くかどうかが決まります。
表の「メモリ帯域」は、机に広げた辞書をチップがめくる速さです。多くのモデルは、1文字書くたびに辞書を読み直します。だから帯域が、答えを書く速さに直結するんですよね。
「AIに回せるメモリ」は、Ollama(ローカルLLMを動かす定番の無料ソフト)が起動するときに自分で決める枠です。16GBのMacだと12GB前後。残りは、macOSとほかのアプリの分です。
AIは文章を細かい区切りで読み書きしていて、日本語だと1区切りが1.5〜2文字でした。この区切りがトークンで、速さは「1秒に何トークン書けるか(tok/s)」で測ります。20 tok/sなら、1秒に30〜40字です。
「コンテキスト」は、辞書の横に原稿を広げるスペースです。読んでいる文章と書いている返事を、まとめて置いておく場所で、広さはトークンで数えます。この広さもOllamaがメモリを見て決めていて、16GBのMacでは4,096トークン(日本語でおよそ6,000〜8,000字)、64GBでは262,144です。64倍違います。
モデルは6本です。「B」はパラメータ(AIの中身を決める数値)の数で、8Bなら80億。多いほど賢くなりやすく、そのぶん辞書も厚くなります。
| モデル | 配布サイズ | 種類 |
|---|---|---|
| Qwen3 8B | 5.2GB | 密 |
| Gemma 4 12B | 8.0GB | 密(小さな下書きモデル付き) |
| Qwen3 14B | 9.3GB | 密 |
| gpt-oss 20B | 13.8GB | MoE |
| Qwen3 30B | 18.6GB | MoE |
| Qwen3 32B | 20.2GB | 密 |
出典:Ollama公式ライブラリのQwen3のタグ一覧、Ollama公式ライブラリのGemma 4のタグ一覧、Ollama公式ライブラリのgpt-ossのタグ一覧
「密」は、1文字書くたびに辞書を全部読むタイプ。「MoE」は、必要なページだけ開くタイプです。Qwen3 30Bなら、128人の専門家のうち8人しか呼びません。同じ厚さの辞書でも、速さと必要なメモリが別物になります。
依頼は、どのMacにも同じ3種類を渡しました。短い質問(「Mac miniを買うか迷っています。3行で背中を押してください。」)、6,000字の動画台本を3行に要約、コンテキストを32,768に広げたうえでの短い質問です。これに加えて、長い文章(3,000字から4万字)の読み込み、10分の音声の書き起こしと整形、答える前にAIが考え事をする「思考オン」でのタイトル案づくりも測りました。
MacBook Air(M1)だけは、16GBをはっきり超えるQwen3 30Bと32Bを見送って4本です。Ollamaの版は4台でそろっていませんが、mini上で2つの版を動かして、速さに差が無いことは確かめました。
メモリ16GB・36GB・64GBで、載るモデルはどう変わる?
16GBは8Bと12Bを1本ずつ、36GBは32Bまで、64GBは6本とも余裕でした。
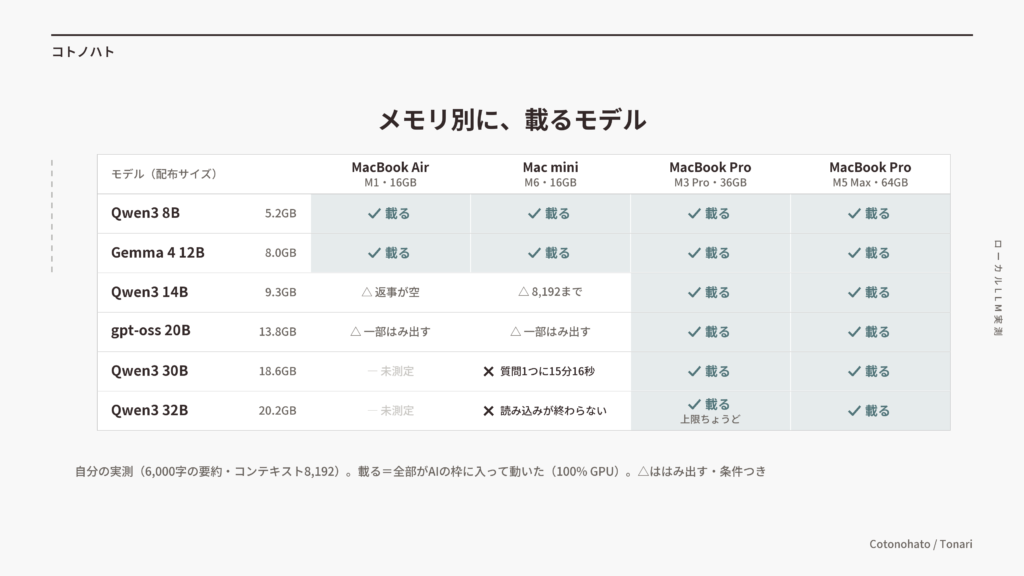
| モデル | Air 16GB | mini 16GB | M3 Pro 36GB | M5 Max 64GB |
|---|---|---|---|---|
| Qwen3 8B(5.2GB) | 載る | 載る | 載る | 載る |
| Gemma 4 12B(8.0GB) | 載る | 載る | 載る | 載る |
| Qwen3 14B(9.3GB) | 返事が空になった | 8,192までは載る。32,768で崩れる | 載る | 載る |
| gpt-oss 20B(13.8GB) | 一部がはみ出す | 一部がはみ出す。日によって動いたり止まったり | 載る | 載る |
| Qwen3 30B(18.6GB) | 未測定 | 動くが使えない(質問1つに15分16秒) | 載る | 載る |
| Qwen3 32B(20.2GB) | 未測定 | 読み込みが終わらなかった | 上限ちょうど | 載る |
出典:自分の実測(2026年9月30日〜10月7日。6,000字の要約・コンテキスト8,192の条件)
「載る」は、辞書が丸ごと机に載った状態です(Ollamaの表示では「100% GPU」)。載りきらない辞書は、はみ出した分を床に置いて、要るたびに取りに行きます。この床がSSDで、床に置いた分だけ、SSDへの書き込みが続きます。
16GB: 8Bと12Bは余裕。14Bは条件つき
Qwen3 8B(5.2GB)とGemma 4 12B(8.0GB)は、コンテキストを32,768に広げても机に載りました。
Qwen3 14B(9.3GB)は条件つきです。コンテキスト8,192までなら載って、miniで14 tok/s前後。32,768に広げると必要なメモリが15GBに増えてはみ出し、短い質問への返事に11分16秒かかりました。8,192のときの、約180分の1の速さです。
さらに大きいgpt-oss 20B(13.8GB)は、机から2〜3割はみ出します。miniでは9月30日に約20 tok/sで動いたものが、10月5日には12.7〜14.1 tok/sになり、同じ日の夜には返事が出る前にSSDへの書き込みが10GBを超えて打ち切りました。はみ出すモデルは、開いているアプリしだいで動いたり止まったりします。
Qwen3 30B(18.6GB)は、断られずに動き出します。ただし0.4 tok/sで、短い質問1つに15分16秒。Qwen3 32B(20.2GB)は、5分26秒たっても読み込みが終わらず、SSDへの書き込みが61.7GBに達したところで止めました。返事は1文字も出ていません。
36GB: 6本とも載る。32Bの密モデルが上限ちょうど
6本とも机に載りました。
いちばん厚いQwen3 32Bを、コンテキスト32,768で載せると28〜29GBです。AIに回せる約30GBの枠を、ほぼ使い切ります。動きましたが5.7〜6.3 tok/sで、6本の中でいちばん遅い。一方、辞書の厚さがほぼ同じQwen3 30B(MoE)は、21GBで41〜48 tok/sでした。厚さではなく、全部読むか一部だけ読むかで、速さが決まっています。
64GB: 6本とも余裕。ただし、素の設定が多く使う
16GBのminiで崩れた条件は、全部ふつうに動きました。Qwen3 14Bの32,768が55 tok/s、Qwen3 30Bが短い質問で110〜128 tok/sです。
ただ、Ollamaの素の設定は、メモリが多いMacほど多く使います。64GBではコンテキストの初期値が262,144になり、Qwen3 30Bを1本載せただけで45GBを使いました。36GBのM3 Proでは、同じモデルが21GBです。設定を触らないだけで、64GBあるのに1本で7割を使う状態になります。
答えを書く速さは、メモリで決まる?
決まりませんでした。決めていたのは、メモリ帯域です。
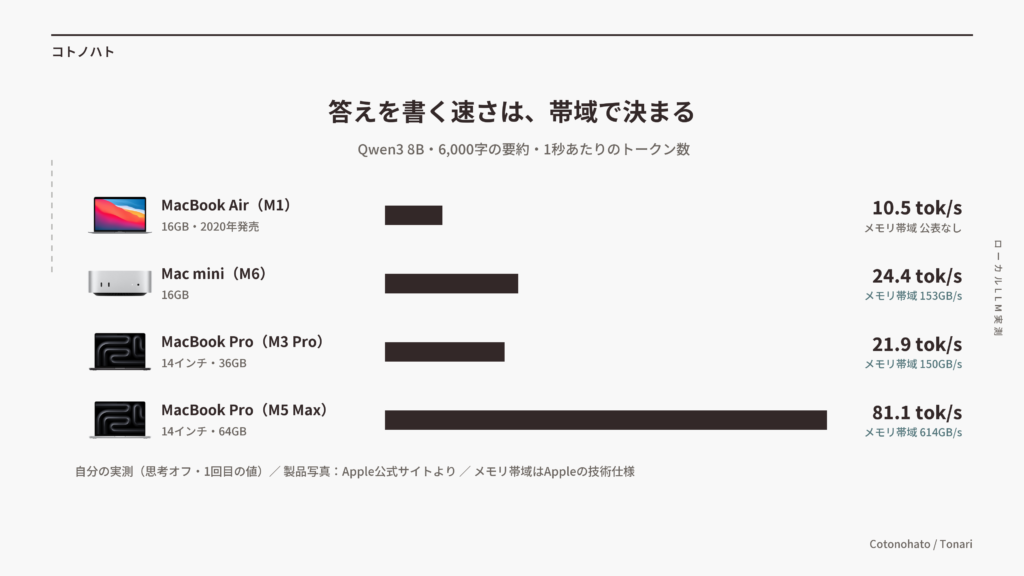
| モデル | Air 16GB | mini 16GB | M3 Pro 36GB | M5 Max 64GB |
|---|---|---|---|---|
| Qwen3 8B | 10.5 | 24.4 | 21.9〜22.4 | 81.1〜83.5 |
| Gemma 4 12B | 6.9〜7.2 | 23.9 | 11.7〜12.0 | 31.6〜54.1 |
| Qwen3 14B | 返事が空 | 13.8 | 13.1〜13.2 | 49.9〜50.7 |
| gpt-oss 20B | 9.8〜11.9 | 12.7(9月30日は19.1) | 30.5〜30.7 | 55.7〜105.8 |
| Qwen3 30B | 未測定 | 中止 | 41.3〜41.9 | 90.0〜98.1 |
| Qwen3 32B | 未測定 | 読み込めず | 6.0 | 14.0〜20.1 |
出典:自分の実測(6,000字の要約・コンテキスト8,192・思考オフ。単位はtok/s。2つあるものは1回目と2回目。M5 Maxの2回目は、バックアップが動いていた時間帯の値で低め)
見てほしいのは、miniとM3 Proです。メモリは16GBと36GB。倍以上違うのに、Qwen3 8Bは24.4と22、Qwen3 14Bは13.8と13.2で、ほぼ同じ速さなんですよね。帯域が153GB/sと150GB/sで近いからです。
密モデルは、1トークン書くたびに辞書を全部読み直します。だから速さは「帯域÷辞書の厚さ」で、だいたい決まる。miniのQwen3 8Bなら、153GB/s÷5.2GBで理論値が29.3 tok/sになります。実測の24.4は、その83%でした。ほかの密モデルも、miniとM3 Proでは理論値の8割前後です(M5 Maxは測定中にバックアップが動いていた回があって、7〜8割台とばらつきます)。
帯域が614GB/sのM5 Maxは、1回目の値で比べると、密モデルでM3 Proの3.4〜4.0倍でした。帯域の比が4.1倍なので、ほぼそのとおりです。MoEは伸びが小さく、Qwen3 30Bで2.3〜2.4倍、gpt-oss 20Bで3.5倍でした。
2020年のMacBook Air(M1)は、同じ16GBのminiの0.43〜0.44倍です(Qwen3 8Bで、3つの条件を通して10.5〜11.8 tok/s)。日本語に直すと、Airは1秒に15〜20字、miniは40字前後、M5 Maxは120字以上になります。
Gemma 4 12Bだけ、この理屈から外れます。このモデルには、先回りして下書きを書く小さなモデルが付いていて、本体がまとめて答え合わせをする仕組みで動きます。下書きが当たれば速くなる。ところが、助けになるかどうかが機種で逆転しました。miniでは1.31〜1.46倍、M5 Maxでは1.24倍速くなり、M3 Proでは0.62〜0.88倍に遅くなり、Airでは変わらなかった。M3 ProでGemma 4を使うなら、下書きを切ったほうが速いです(Ollamaの設定で draft_num_predict を0にします)。逆転の理由は分かっていません。
長い文章を読ませると、どれだけ待つ?
答えを書く速さとは別に、渡した文章を読み込む速さがあります。こちらは帯域ではなく計算の速さで決まるので、チップの世代で差が出ました。
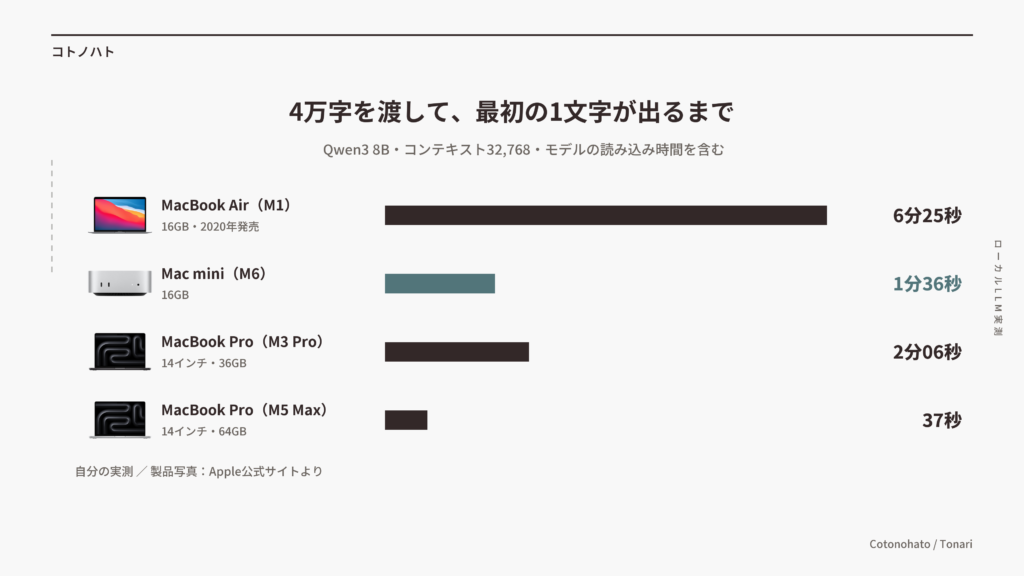
| 渡した文章 | Air 16GB | mini 16GB | M3 Pro 36GB | M5 Max 64GB |
|---|---|---|---|---|
| 3,000字 | 19.6秒 | 5.4秒 | 8.2秒 | 2.0秒 |
| 6,000字 | 34.3秒 | 6.5秒 | 12.4秒 | 2.4秒 |
| 13,000字 | 1分29秒 | 16.6秒 | 29.7秒 | 6.0秒 |
| 26,000字 | 3分31秒 | 44.8秒 | 1分08秒 | 17.1秒 |
| 40,000字 | 6分25秒 | 1分36秒 | 2分06秒 | 37.0秒 |
出典:自分の実測(Qwen3 8B・コンテキスト32,768・最初の1トークンが出るまで。モデルの読み込み時間を含む)
答えを書く速さがほぼ同じだったminiとM3 Proが、ここでは差がつきます。4万字を渡してから最初の1文字が出るまで、miniは1分36秒、M3 Proは2分06秒、Airは6分25秒です。読み込みそのものの速さ(6,000字のとき)は、miniがM3 Proの約2倍、Airはminiの約6分の1でした。
入力が長いほど、読み込みは遅くなります。miniのQwen3 8Bは、3,000字のとき毎秒755トークン、4万字のとき270トークンでした。「読み込みは毎秒何トークン」と、1つの数字では言えません。
4万字は、この記事の4〜5本分です。Airに渡すと、最初の1文字まで6分半。1万3千字でも、Airは1分半、miniは17秒、M5 Maxは6秒です。
10分の音声を文字にして整形するまで、何分かかる?
実際の作業に近いテストもしました。題材は、前回の動画の冒頭10分の音声です。
まず、Whisper(音声を文字に起こすAIモデル)で書き起こします。使ったのは、mlx-communityがHugging Faceで公開しているwhisper-large-v3-turboです。出てきた5,338字をGemma 4 12Bに渡して、読みやすい文章に整形してもらいます。
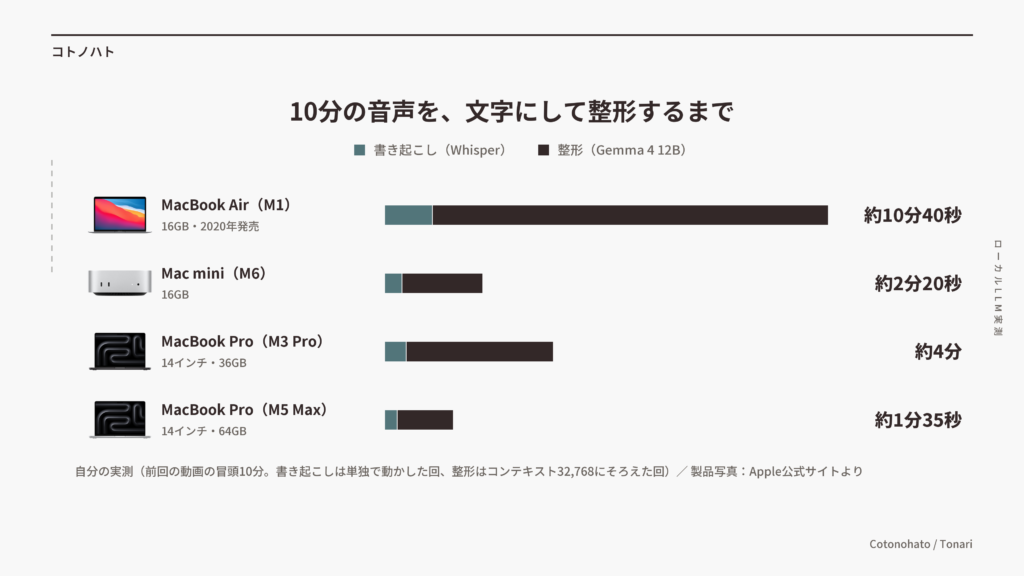
| Air 16GB | mini 16GB | M3 Pro 36GB | M5 Max 64GB | |
|---|---|---|---|---|
| 書き起こし(Whisper) | 65〜68秒 | 20〜24秒 | 28〜30秒 | 13〜17秒 |
| 整形(Gemma 4 12B) | 9分34秒 | 1分56秒 | 3分32秒 | 1分20秒 |
| 合計 | 約10分40秒 | 約2分20秒 | 約4分 | 約1分35秒 |
出典:自分の実測(Whisperは単独で動かした回、整形はコンテキストを32,768にそろえた回)
Airは、音声とほぼ同じ時間を待ちます。 miniは2分20秒で、メモリが倍以上あるM3 Proの約4分より速い。帯域はほぼ同じなのに差が出たのは、Gemma 4の下書きモデルが、miniでは助けになり、M3 Proでは足を引っぱったからです。
16GBのコツは、書き起こしのAIと整形のAIを同時に載せないことです。miniでGemma 4を載せたままWhisperを動かすと、空きメモリが残り3%になって、書き起こしが1.6〜1.9倍遅くなりました。1つずつ順番に動かせば、SSDへの書き込みはほとんど出ません。
整形の中身は、4台とも同じ傾向でした。書き起こしの時点で入っていた「トモリ」という聞き間違いは、どのMacでも直らずに残る。主語の無い文に「私」を足した回も、4台中3台にありました(話し手が誰か分からないまま、AIが決めてしまう癖です)。機種を替えても、出てくる文章の質は変わりませんでした。
16GBで使うなら、落とし穴が3つ
どれも、エラーが出ません。だから気づきにくいんですよね。
1. 素の設定だと、長い仕事が黙って半分で止まる
コンテキストは、辞書の横に原稿を広げるスペースでした。16GBのMacだと、Ollamaはこの広さを4,096トークンに決めます。
10分の音声の整形を、設定を変えずにやると、途中で止まりました。渡した書き起こしが2,722トークン。返事を1,372トークン書いたところで、合計4,094トークン。上限です。出てきたのは2,810字で、元の文章の約半分。「同時に開く」という言葉のところで、文が切れたまま終わります。エラーは出ません。
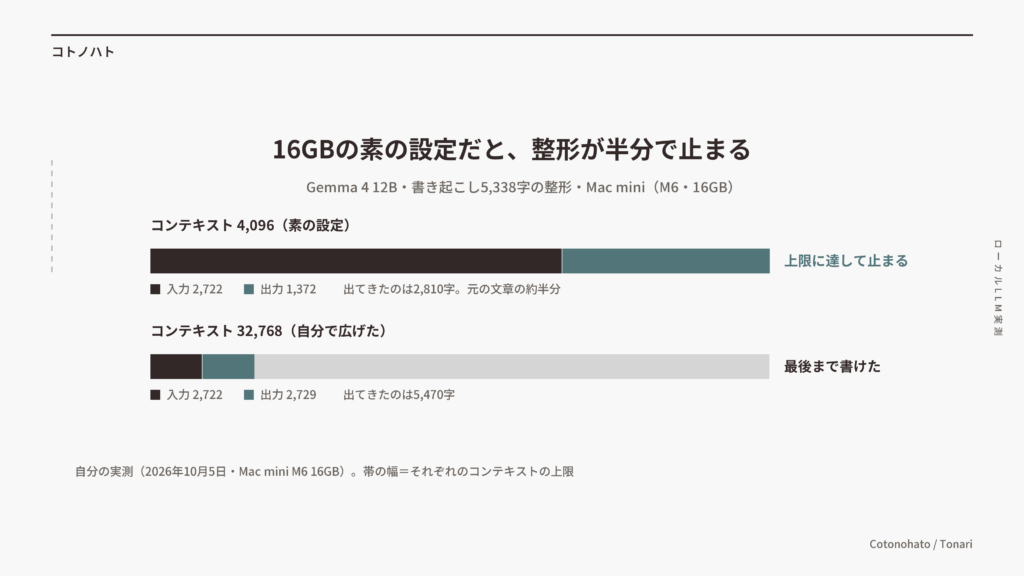
コンテキストを32,768に指定してやり直すと、5,470字で最後まで書いてくれました。16GBで長い文章を扱うなら、コンテキストは自分で広げる。 広げ方はOllama公式ドキュメントのコンテキスト長のページにあります。気づかないと、半分の文章を全部だと思って使うことになります。
2. 広げすぎると崩れる。2つ同時に載せない
じゃあ全部32,768にしておけばいいかというと、モデルによりました。Qwen3 8BとGemma 4 12Bは、広げても机に載ります。Qwen3 14Bは15GB必要になってはみ出し、上で書いた11分16秒になります。gpt-oss 20Bも、32,768に広げると依頼1回で30〜44GBをSSDに書き込みました。
2つのモデルを同時に載せたときも同じです。Gemma 4を載せたままWhisperを動かすと、空きメモリが1〜3%になって、SSDへの書き込みが始まります。
3. はみ出したモデルは、SSDに書き込み続ける
はみ出したモデルは、エラーにならずに動いてしまいます。入りきらない分をmacOSがSSDに一時的に逃がして、要るたびに読み戻すからです(スワップと呼ばれる動きです)。その裏で書き込みが続き、Qwen3 30Bのときは毎秒約218MBでした。
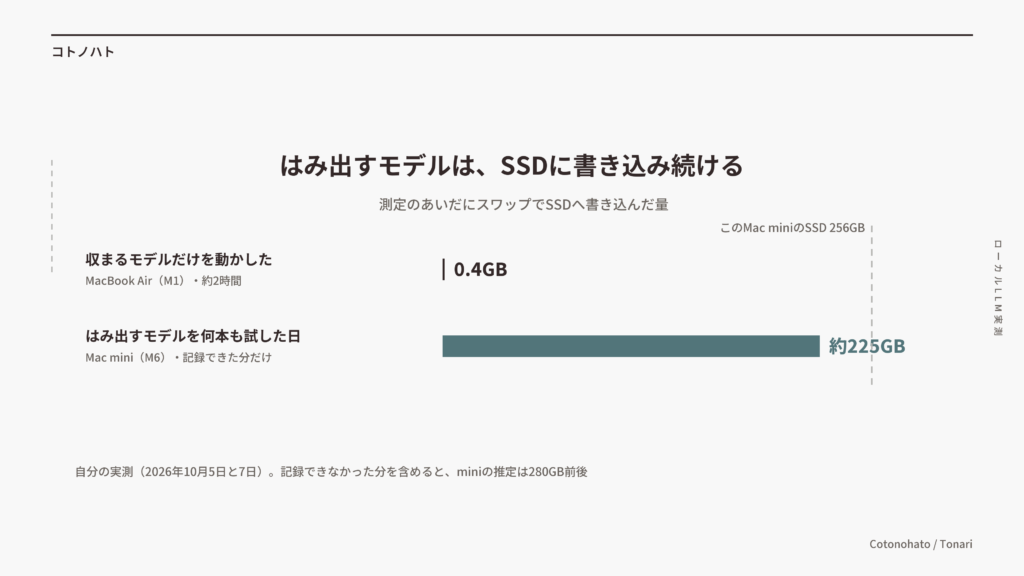
10月5日のminiでは、はみ出すモデルを何本も試して、記録できた分だけで約225GBを書き込みました。記録できなかった分も入れると、推定で280GB前後です。このminiのSSDは256GB。 推定では、SSDの容量より多い量を、測定だけで書き込んだことになります。
逆に、載るモデルだけを動かした回は、ほとんど書き込みが出ていません。miniだとWhisperだけなら0GB、Gemma 4の整形で1.2GB。Airでは載るモデルの測定を約2時間ぶん合わせて0.4GBでした。SSDは書き込める回数に限りがある部品で、寿命にどれだけ響くかは測っていません。はみ出すモデルを試すなら、短い質問を1回だけにして、終わったらモデルを外す(Ollamaなら keep_alive を0にするか、サーバーを止める)のがいいと思います。
2020年のMacBook Air(M1)だけに出たこと
同じ16GBでも、Airにはminiと違うことが2つありました。
Qwen3 14Bにコンテキスト8,192で台本の要約やタイトル案を頼むと、5回とも返事が空でした。ここでもエラーは出ません。Ollamaのログには、GPUのメモリ不足が記録されていました。AIに回せるメモリは、miniの12.7GBに対してAirは11.5GB。この差が原因かどうかは分かっていません。miniでは同じ条件が動きます。
Airにはファンが無いので、同じ依頼を10分くり返すテストもしました。Qwen3 8Bで11.56 tok/sから10.40 tok/sへ、10分で10%下がりました。崖のように落ちる場面は無かったです。ただ、10分より先は測っていません。
同じモデルなら、高いMacで答えは賢くなる?
ならなかった。変わったのは待ち時間だけでした。 賢さを変えるのは、Macではなくモデルの側です。
AIの答えは、同じ質問でも毎回少し変わります。その揺れ方を固定する番号があって、seedと呼ばれています。Qwen3 8Bに、思考オンで動画のタイトル案を同じseedで頼んだら、4台とも、考え事も答えも1文字も違わないものが返ってきました。seedを変えてもう1回やっても、やはり4台で同じ。
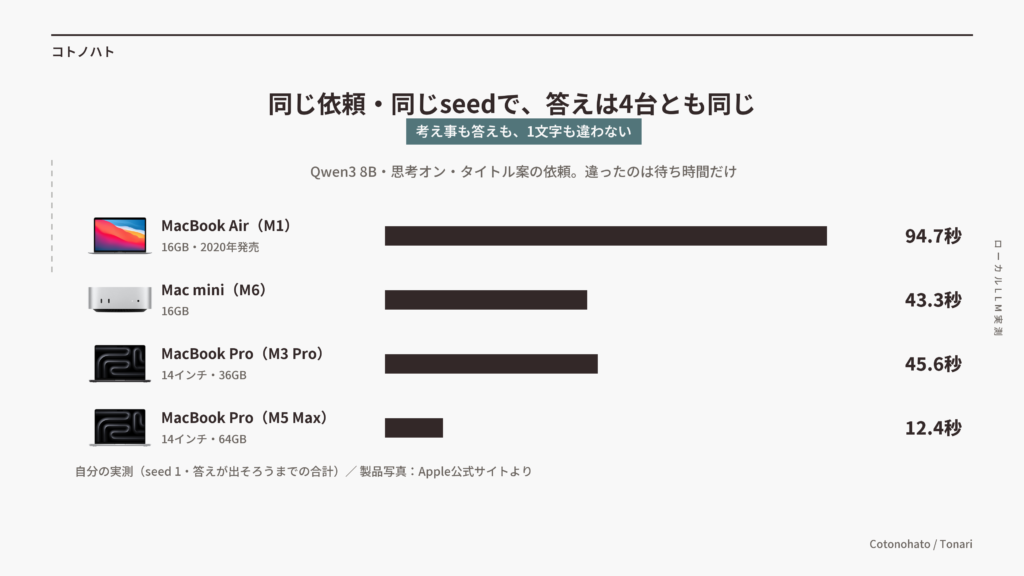
| Air 16GB | mini 16GB | M3 Pro 36GB | M5 Max 64GB | |
|---|---|---|---|---|
| seed 1 | 94.7秒 | 43.3秒 | 45.6秒 | 12.4秒 |
| seed 2 | 89.2秒 | 37.5秒 | 40.0秒 | 11.0秒 |
出典:自分の実測(Qwen3 8B・思考オン・タイトル案の依頼文2,146字・答えが出そろうまでの合計)
Airで1分半待つ答えと、M5 Maxで12秒で出る答えが、同じなんですよね。64GBで増えたのは、載る大きさと待ち時間の短さだけで、賢さではありませんでした。
ただし、これはQwen3 8Bのこの依頼での話です。Gemma 4 12Bは、Macによって違う文章になる回がありました。M3 ProとM5 Maxで12本のタイトル案を比べると、一致したのは3本。機種が変わると計算の細かい結果が変わって、選ばれる言葉が変わることがある。ただ、答えの良し悪しが機種で決まるとまでは言えません。
思考オンにすると、答えが出始めるまでの待ちが、miniで3〜5秒から18〜55秒に延びました。それでもminiで1分前後、M3 Proでも長くて5分以内に答えは出ます。6本のモデルに思考オンで24回頼んで、M5 MaxもM3 Proも24回とも答えまで届きました。
正直、答えの中身は今回ほとんど確かめられていません。見えた範囲では、思考オフだと崩れた回がありました。Qwen3 8Bは台本に無い「裏技」「秘密」という言葉を入れてきて、Qwen3 14Bは答えの前に台本の続きを勝手に数行書きました。思考オンだと、6回とも5案と理由の形で返ってきて、依頼文に無い数字は出ていません。どれも1〜2回の結果なので、どちらの設定がいいとまでは言えないです。
結局、ローカルLLMのためにメモリはいくつ要る?
やりたいことで分けました。
| やりたいこと | 今回動いたメモリ | 条件 |
|---|---|---|
| 8B〜12Bを1本ずつ。短い依頼や、10分の音声の整形 | 16GB | コンテキストを自分で広げる。2つ同時に載せない |
| 14B〜32Bも使う。複数のモデルを入れ替えながら使う | 36GB | 32Bの密モデルは上限ちょうどで、5.7〜6.3 tok/s |
| 6本どれでも余裕を持って。待ち時間を短く | 64GB | 速さを決めるのは帯域。素の設定はコンテキストを広げすぎる |
メモリを増やすことと、速くなることは、別の買い物です。 同じM6 Mac miniでも、AppleのMac mini技術仕様ページによると、帯域は16GBが153GB/s、24GB以上が170GB/sです。M5 Maxは、AppleのMacBook Pro技術仕様ページで32コアGPUが460GB/s、40コアGPUが614GB/sとされています。答えを書く速さが欲しいなら、見るのはメモリの量ではなく、この数字のほうだと思います。
「載らないモデルは動かない」は、ふつうの動かし方の話です。必要な部品だけをSSDから読みながら動かす実行環境(オープンソースのSlotStream(GitHub))を使うと、105GBあるQwen3.8-Flash-Next(部品を使い分けるMoEの大きなモデル)が、36GBのM3 Proで5.7〜6.9 tok/s、64GBのM5 Maxで13〜18 tok/sで動きました。専用の実行環境を使った場合の話なので、上の表には入れていません。2台だけのテストなので、ここでは数字だけにとどめます。
前回の動画では、「ローカルのAIを動かすなら16GBは選ばないほうがいい」と言いました。
小さいモデルでローカルLLMを試すというのも興味くらいならいいですが、実用性はないので、ローカルLLM文脈なら、せめて32GBはいると思います
手元に16GBのMacがあるなら、8Bか12Bのモデル(たとえばQwen3 8BかGemma 4 12B)を1本入れて、自分の作業を1つ頼んでみる価値はあります。ただ、それを毎日の作業に組み込むつもりなら、吹き出しのとおり、メモリは多めに見ておいたほうがよさそうです。
むすびに
- メモリで変わるのは、載るモデルの大きさ。16GBは8B〜12Bを1本ずつ、36GBは32Bまで、64GBは6本とも余裕
- 答えを書く速さを決めるのは帯域。16GBのM6 miniと36GBのM3 Proはほぼ同じ速さで、614GB/sのM5 Maxは約4倍
- 同じモデル・同じseedなら、4台で同じ答えが出た。高いMacで買えるのは、待ち時間の短さと載る大きさ
- 16GBで使うなら、コンテキストを自分で広げる、2つ同時に載せない、はみ出すモデルを回し続けない
- 自分の結論は、小さいモデルを興味で試すなら16GBでもいいが、ローカルLLMが目的ならせめて32GB
メモリを「盛る・盛らない」を決める前に、動かしたいモデルの大きさと、どれだけ待てるかを決める。4台の数字は、その順番で見ると使いやすいと思います。
それではまた。